 MagicDB Studio
AI 增强工具
从 SQL 生成与执行计划分析,到同步策略、差异诊断和测试数据规则推断:让 AI 提供候选方案,由操作者保留最终判断。
适用场景
AI 增强工具适合把“理解结构、形成候选 SQL、定位问题、准备执行方案”串成可审查的工作流,而不是替代数据库权限控制、变更审批或结果校验。
可视化执行计划与 SQL 片段
- 可视化执行计划:对选定查询调用真实的
EXPLAIN,将访问方式、扫描行数、节点关系与开销整理为结构化视图。MySQL / PostgreSQL 可解析 JSON 格式,其他数据库可能回退为通用文本计划。 - SQL 代码片段:把经过验证的统计查询、故障排查语句和运维模板按分类、关键词持久化管理,减少重复输入;片段复用前仍要核对当前连接、库名与参数。
AI 同步策略、差异诊断与生成规则
- 同步策略:根据源端、目标端、数据量、频率和约束,给出全量、增量、CDC 或混合模式候选方案,并提示水位字段、删除与冲突处理、重试、限流、校验和回滚。它只生成建议,不会替你证明方案可用或自动完成同步。
- 差异诊断:根据数据对比摘要,按可能性分析同步延迟、主键映射、时区、过滤条件、类型转换和软删除等原因,并给出验证 SQL 或检查项。诊断必须用源端与目标端实测结果逐项证伪或确认。
- 生成规则:读取目标表结构后,为姓名、手机号、日期、枚举、UUID、序列等列推荐测试数据规则;推断结果可手动调整,生成前应检查唯一键、外键、非空、范围和业务约束。
入口路径
| 能力 | 入口 | 进入后先确认 |
|---|---|---|
| AI Provider | 设置 → AI 助手 | Provider、API Key、模型与自定义 Base URL 是否对应 |
| 自然语言生成 SQL | SQL 工作台编辑器顶部 Prompt Bar;可用 Ctrl + K 打开 | 当前连接、数据库、Schema 与目标表 |
| 解释、优化、风险检查 | 在工作台选中 SQL,使用选中内容对应的 AI 快捷操作 | 选区是否完整,SQL 方言是否与当前连接一致 |
| 执行计划、SQL 片段、同步策略、差异诊断 | 顶部菜单 → 工具中心 → AI & BI | 输入内容是否已最小化,是否包含必要的统计信息与约束 |
| AI 推断生成规则 | 工具中心 → 数据工具 → 数据生成器 → 选择目标表后使用 AI 推断规则 | 目标表与环境是否正确,是否允许写入测试数据 |
不同能力的入口承担不同职责:工作台负责围绕当前 SQL 和 Schema 生成或解释;工具中心负责场景化建议;数据生成器负责把规则候选落到具体列。若界面未出现对应入口,先检查当前版本和 Provider 配置,不要臆造点击路径。
前置条件
- 准备可用连接:先完成数据源连接与连通性验证,并确认账号只拥有当前任务必需的权限。执行计划需要数据库允许执行相应的
EXPLAIN。 - 自行配置 AI 服务:在「设置 → AI 助手」选择 Provider,填写有效 API Key 与模型;使用兼容服务时再设置 Base URL。模型名称和服务配额由所选 Provider 决定。
- 限定数据范围:只提供生成或诊断所需的表名、列名、类型、索引、少量统计摘要和脱敏样例。不要把整库数据、生产凭据、访问令牌或无关业务内容加入上下文。
- 准备验证与回退:涉及同步、迁移、导入、恢复或数据生成时,先做可恢复备份,选择非生产环境和小数据集演练,并准备行数、校验和、抽样或业务指标等验收口径。
编号步骤
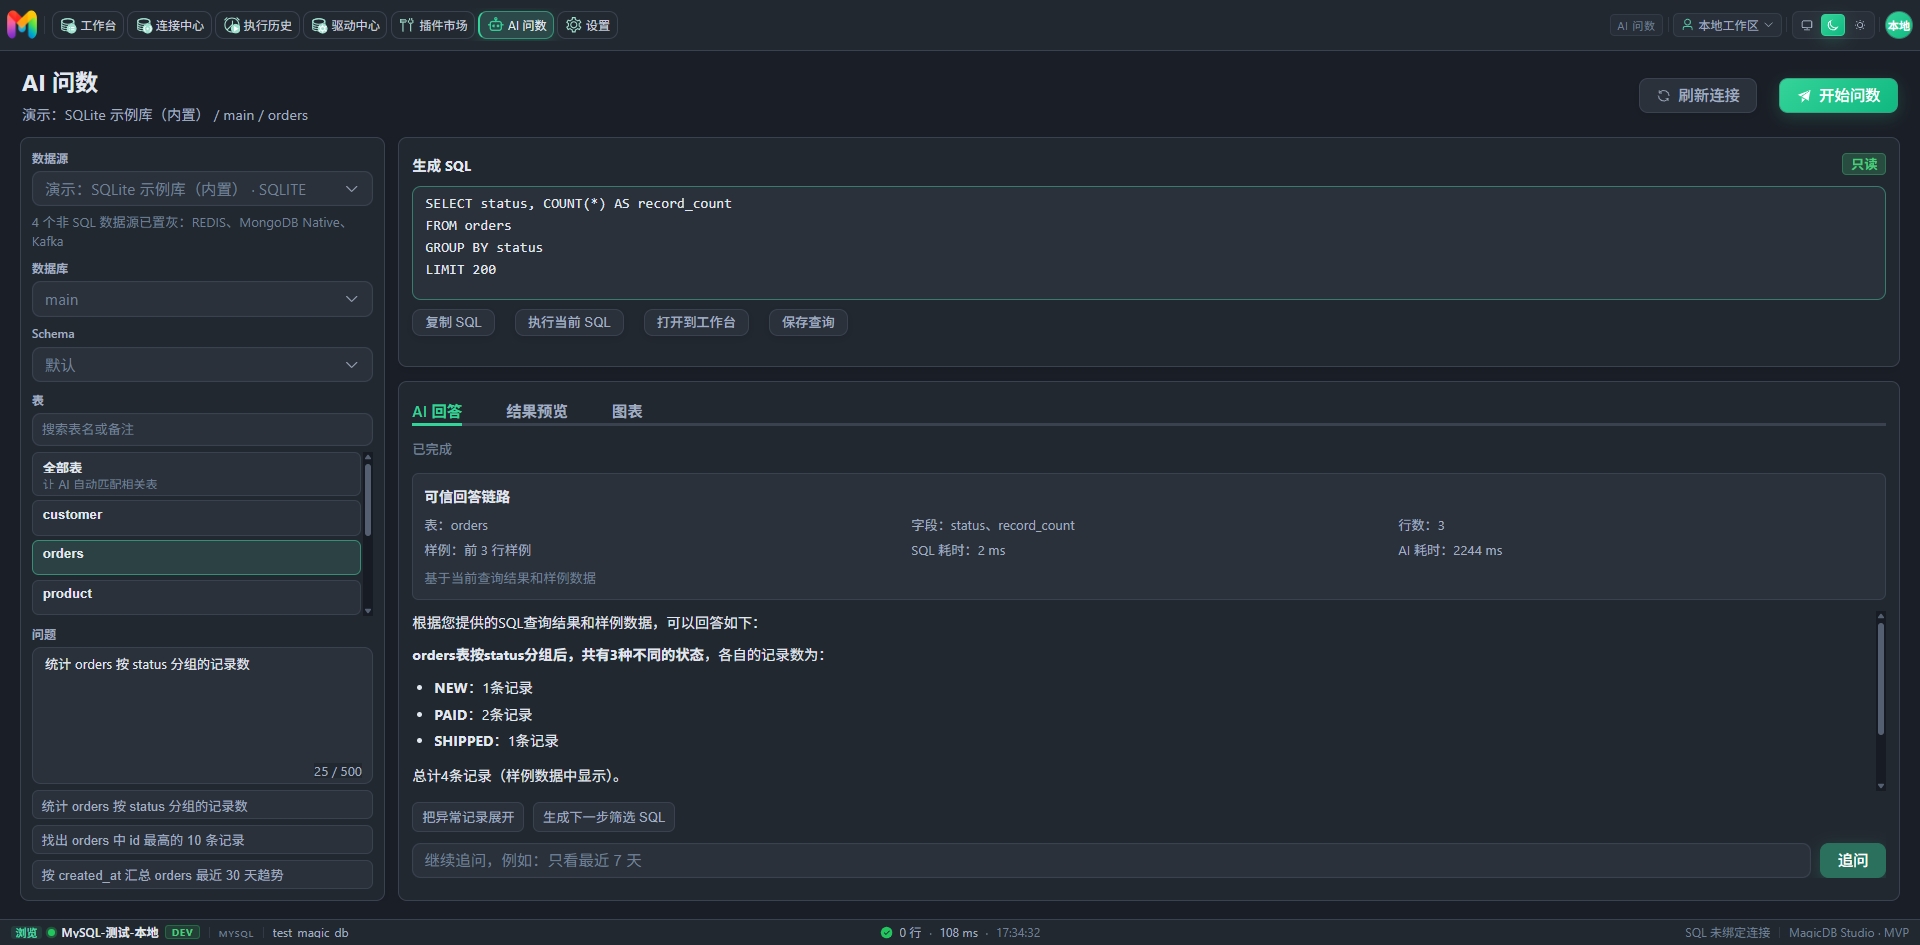
下面以“生成查询并核对结果,再根据需要分析计划或诊断差异”为主线。所有生成内容先进入预览 / 编辑阶段,不直接视为可执行结论。
- 锁定环境与目标。在 SQL 工作台选择正确的连接、数据库和 Schema,写清要回答的业务问题、结果粒度、过滤范围和目标数据库方言。生产环境优先切换到只读账号或等价的受控连接。
- 裁剪上下文并发起生成。打开 Prompt Bar,只提供相关表、关联键、必要列和脱敏样例,用明确约束描述需求,例如“按自然月汇总已支付订单,不包含取消记录,输出月份、订单数与金额”。
- 逐句人工复核 SQL。检查表名、连接条件、聚合粒度、NULL 处理、时区、过滤条件、排序与分页;重点排除笛卡尔积、遗漏租户条件、无界扫描和写操作。发现问题时先修改提示或 SQL,不要直接执行。
- 先预览执行计划。对候选查询使用可视化执行计划,核对访问路径、估算扫描行数、索引使用和高开销节点。计划是优化线索,不等于真实耗时;必要时在隔离环境用受控数据量实测。
- 小范围执行并对照结果。先增加时间范围或行数限制,执行后核对行数、关键聚合值和边界样本,再逐步扩大范围。可以把确认过的语句保存为 SQL 片段,但应在片段名称或说明中标注适用库、参数和前置条件。
- 诊断同步差异。从数据对比结果提取最小摘要,例如缺失 / 多余 / 值不同的数量、主键范围、时间分布和字段特征,请 AI 给出按可能性排序的原因及验证 SQL。逐条在源端和目标端执行检查,记录证据后再决定修复。
- 复核同步或生成方案。同步建议需补齐主键 / 水位字段、删除语义、冲突策略、重试幂等、限流、校验和回滚;生成规则需检查唯一键、外键、非空和业务范围。先预览、备份并在测试环境小批量验证,确认无误后才进入正式流程。

参数说明
| 参数 / 输入 | 如何填写 | 检查重点 |
|---|---|---|
| Provider | 选择你自行开通并可访问的 AI 服务 | 数据处理条款、网络可达性、配额与计费由对应服务决定 |
| API Key | 填写该 Provider 签发的有效凭据 | 不要写入 SQL、Prompt、截图或共享片段;失效时到 Provider 侧轮换 |
| 模型 | 填写服务实际支持的模型标识 | 确认模型仍可用且适合代码 / SQL;不要依赖示例名称永久有效 |
| Base URL | 仅兼容服务或代理场景按服务说明配置 | 地址、协议和接口兼容性;普通官方接入通常不必修改 |
| Schema 上下文 | 仅保留相关表、字段类型、主外键、索引和必要注释 | 最小化、脱敏,避免发送真实敏感值和无关对象 |
| 查询目标 | 明确指标口径、过滤范围、聚合粒度、排序、分页和 SQL 方言 | 业务定义是否无歧义,是否遗漏租户 / 权限 / 时间条件 |
| 同步场景 | 说明源 / 目标、数据量、频率、主键、水位、删除语义与停机窗口 | 幂等、冲突、重试、限流、校验、备份和回滚必须完整 |
| 差异摘要 | 提供差异类型、数量、主键 / 时间分布和少量脱敏样本 | 先确认源目标方向和对比口径,避免让错误摘要误导诊断 |
| 生成规则 | 按列设置生成器、范围、枚举、NULL 比例、唯一性和行数 | 外键依赖、唯一约束、日期边界和写入环境 |
预期结果
完成一次可靠的 AI 辅助流程后,应得到可检查的中间产物,而不是只有一句“已优化”或“建议同步”。
- 生成 SQL:候选语句已进入编辑器,方言、对象、关联、过滤、聚合和返回列均可逐句审阅;小范围执行结果能回答原始问题。
- 执行计划:能够看到计划节点、访问方式、扫描行数 / 估算开销等信息;已记录潜在全表扫描、连接顺序或索引问题,并区分估算与实测。
- SQL 片段:保存的是已验证版本,名称、分类、关键词和适用条件足以让后续使用者判断是否可复用。
- 同步策略:至少覆盖模式、增量依据、删除与冲突、失败重试、限流、校验、切换和回滚;在备份及测试演练完成前不进入生产执行。
- 差异诊断:每个成因都有对应检查项或验证 SQL,并由真实数据证据确认 / 排除,而非仅凭模型排序下结论。
- 生成规则:每列规则可编辑,预览样本符合格式与约束;小批量写入后通过行数、唯一键、外键和业务规则检查。
常见问题
1. 已配置 Provider,但 AI 入口没有输出怎么办?
先核对 Provider、API Key、模型标识和 Base URL,确认服务配额、网络和兼容接口可用;再用更短、无大段 Schema 的请求重试。不要为了排错把 API Key 粘贴到 Prompt、截图或日志中。
2. AI 生成的 SQL 引用了不存在的字段,或方言不正确怎么办?
确认工作台当前连接与 Schema,刷新相关元数据,并在提示中明确数据库类型和只允许使用的表 / 字段。将输出视为草稿,手工修正后先执行计划、小范围查询和结果抽样;无法确认时不要执行。
3. 同步策略写得很完整,可以直接用于生产吗?
不可以直接据此上线。先让数据负责人补齐主键、水位、删除、冲突与停机窗口,创建可恢复备份,在测试环境演练全量 / 增量、失败重试和回滚,再用行数、校验和及业务指标验收。
4. AI 差异诊断给出多个原因,应该先修哪一个?
不要按文本顺序直接修。先验证成本低且可证伪的项目,例如对齐时区、过滤条件和同步水位,再检查主键映射、类型转换及软删除。每一步保存源 / 目标查询证据,只有确认根因后才生成修复脚本。
5. AI 推断的测试数据规则会自动满足所有约束吗?
不会。推断规则只是起点,必须人工检查唯一键、复合键、外键、CHECK 约束、非空、枚举和字段长度。先预览样本并在测试环境小批量生成;已有数据应先备份,避免覆盖或污染可复用测试集。
6. 为什么找不到查询构建器或 BI 仪表盘的完整操作页?
这两项目前属于规划 / 开发中能力,尚不能按已上线功能提供稳定入口或操作承诺。请以未来正式发布说明为准,当前查询仍使用 SQL 工作台,结果核对仍以工作台现有视图为准。