 MagicDB Studio
AI Assistant
AI SQL 工作流
从 Provider 配置到生成、解释、追问与人工审阅,用可控流程把自然语言转为可验证的 SQL。
执行原则:AI 输出是候选方案,不是数据库事实或执行授权。任何 SQL,尤其是 DDL、UPDATE、DELETE 和高开销查询,都应先核对目标连接、方言、对象、过滤条件与影响范围,再由人决定是否执行。
适用场景
AI SQL 工作流适合加速“理解需求—形成 SQL—验证结果”的迭代过程,而不是替代数据库权限控制、业务确认或变更审批。
- 从自然语言起草查询:把统计口径、筛选范围、分组与排序要求转换为 SQL 初稿。
- 理解已有 SQL:解释连接关系、聚合逻辑、子查询、窗口函数及可能产生重复行的位置。
- 优化与改写:请求等价改写、索引方向或执行计划排查建议,再结合真实执行计划验证。
- 带上下文问答:围绕当前连接、选定表、当前 SQL 或查询结果继续追问,缩短补充背景的过程。
不建议把 AI 直接用于无人值守的数据修改、权限变更、生产结构变更,或要求模型对账务、合规和业务口径作最终裁决。
入口路径
根据任务选择入口,先确认界面显示的连接与数据库上下文:
- Provider 配置:顶部「设置」→「AI 助手」,选择服务商,填写 API Key、模型及必要的 Base URL。
- 自然语言生成 SQL:在 SQL 工作台打开 AI 生成 SQL 入口,输入完整需求后生成候选语句。
- 解释或优化:在编辑器中选中目标 SQL,再使用 AI 的解释、优化或改写能力。
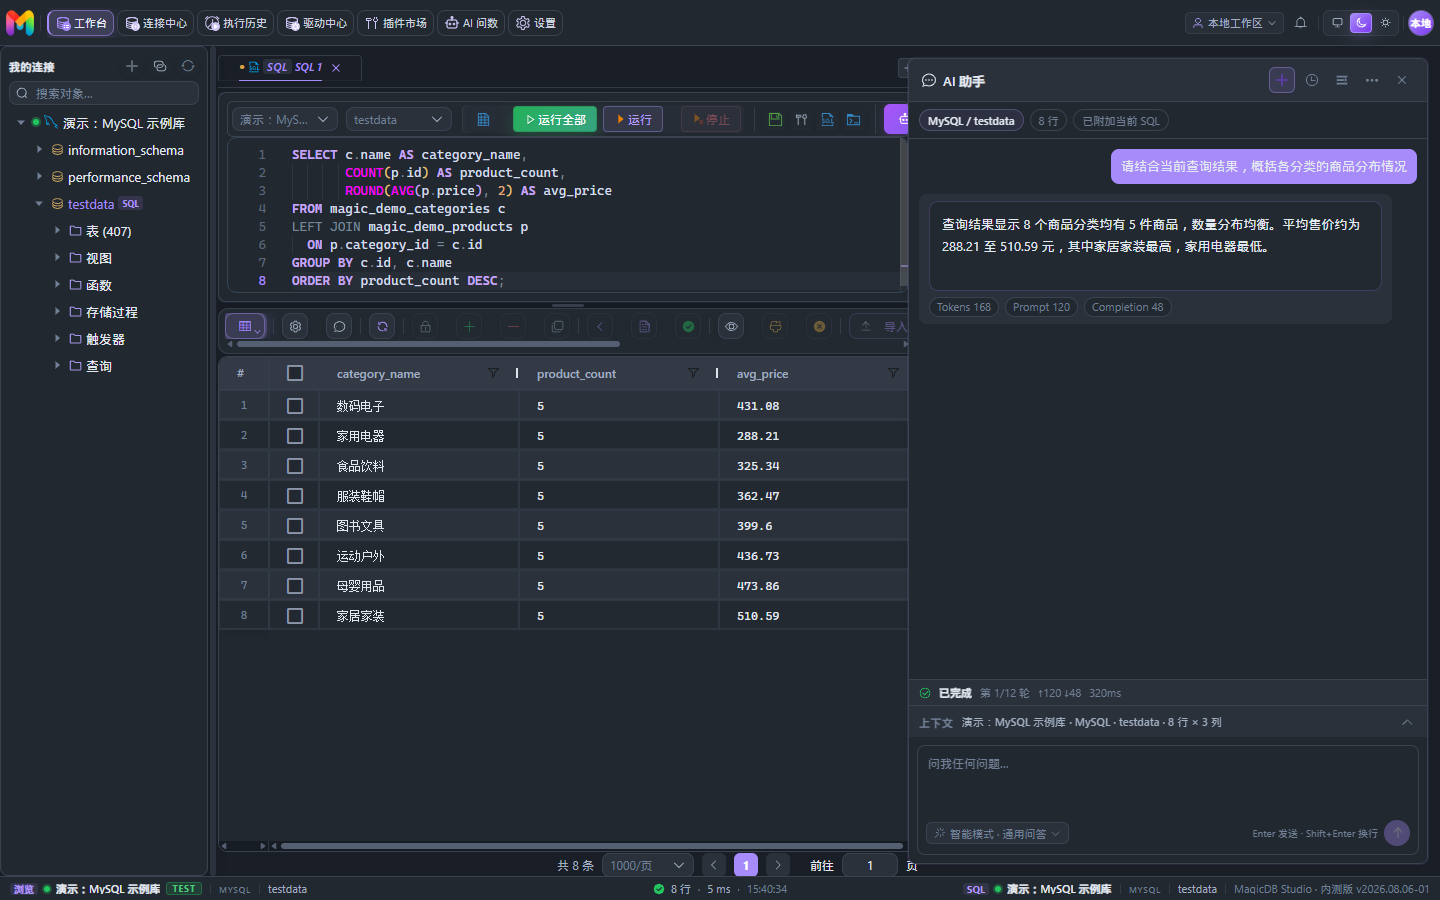
- 上下文问答:打开 AI 助手侧栏,围绕当前 SQL、已关联的 Schema 或当前查询结果继续提问。
SQL 工作台 · AI 助手侧栏
前置条件
- 准备可用的 Provider 账号:自行向所选模型服务商申请 API Key,并了解其计费、限流、数据处理和地区政策。
- 完成模型配置:在「设置 → AI 助手」选择 Provider 与模型;使用兼容接口时,按服务商文档填写 Base URL。模型名称必须是该账号实际可调用的名称。
- 建立并确认数据库连接:在工作台选择正确的连接、数据库与 Schema。生成质量依赖可用上下文,元数据不完整时应在提示中明确表名、字段与关系。
- 收紧执行权限:探索生产数据时优先使用只读账号;需要修改数据时,先准备备份或可回滚方案,并按团队流程审批。
- 划定隐私边界:发送请求前判断 SQL、Schema、样例值或结果集是否可提交给第三方模型。不要在提示中粘贴密码、Token、个人敏感数据或未获授权的业务数据。
模型选择提示:不同 Provider 和模型在 SQL 方言、长上下文、结构化输出、响应速度与费用方面能力不同。先用脱敏的小样例验证,再决定是否用于更复杂任务。
编号步骤
- 绑定正确上下文。打开目标连接和 SQL Tab,核对连接名称、数据库、Schema 与关键表。若只需查询少量表,应明确点名,避免模型在同名对象之间猜测。
- 写出可验收的自然语言需求。同时说明数据库方言、目标表、字段、连接条件、时间范围、过滤条件、聚合口径、排序、空值处理和返回行数。例如:“使用当前 PostgreSQL Schema,按自然月统计已支付订单金额,仅返回最近 6 个月,按月份升序,限制 100 行。”
-
生成 SQL 初稿并停在预览阶段。选择已配置的 Provider / 模型后生成,先阅读生成结果;使用“新 SQL 窗口”“追加到末尾”“替换当前窗口”或“复制”等操作时,避免覆盖尚未保存的 SQL。
AI 生成 SQL · 结果预览

生成结果预览:生成内容先停留在对话框中,可新建 SQL 窗口、追加、替换或复制;操作前应确认目标窗口与生成语句完整性。 - 逐项人工审阅。检查方言和标识符引用是否正确,JOIN 是否遗漏条件,WHERE 是否过宽,聚合口径与时区是否符合需求,是否意外包含 DDL / DML,以及 LIMIT 是否满足探索阶段的范围控制。
- 先验证,再执行。查询语句可先缩小时间范围并加 LIMIT;复杂 SQL 先查看执行计划,确认没有不可接受的全表扫描或笛卡尔积。修改语句先在测试环境运行,并在事务或备份条件允许时验证影响行数与回滚路径。
- 解释、优化并验证等价性。选中 SQL 请求 AI 解释或优化,要求它明确列出“改动点、依据、风险与验证方式”。优化建议必须用真实执行计划、索引定义、数据量和执行耗时复核;改写前后应比较结果行数、关键聚合值与边界样例。
-
基于结果继续追问。执行只读查询并确认结果可信后,再询问异常值、分组差异或下一步查询。每次追问都重新确认当前上下文,必要时要求 AI 只给分析或 SQL,不自动执行。
AI 问数 · SQL 与回答链路
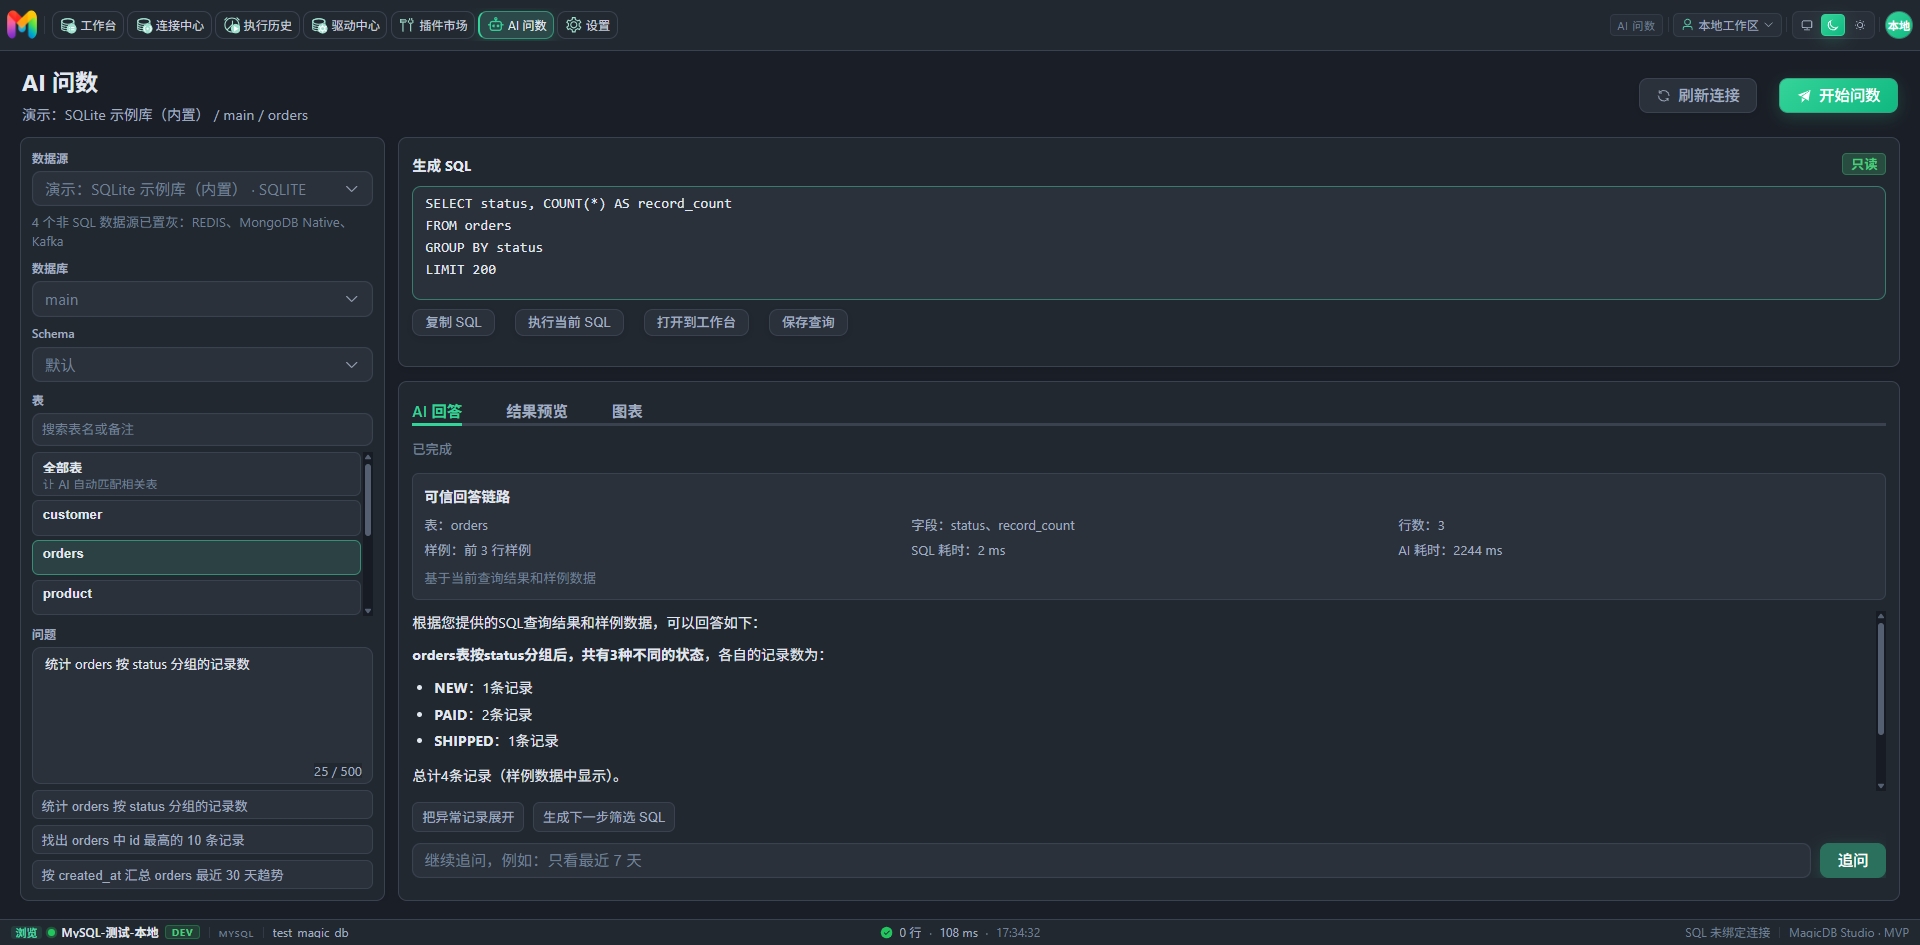
可核查的问答链路:页面同时展示选定表、生成 SQL、结果信息与 AI 回答,便于对照查询口径;回答仍需以数据库实际结果为准。
参数说明
| 参数或上下文 | 如何设置 | 检查重点 |
|---|---|---|
| Provider | 在「设置 → AI 助手」选择实际使用的模型服务商。 | 账号可用性、计费与限流、数据处理政策;请求会发往所选第三方服务。 |
| API Key | 填写服务商签发的凭据,不要放入 SQL、提示词或截图。 | 权限范围、有效期与余额;泄露后应立即在服务商侧撤销或轮换。 |
| 模型 | 填写或选择当前账号有权调用的模型名称。 | 是否支持所需上下文长度和 SQL 推理;不要照搬可能失效的示例名称。 |
| Base URL | 仅在兼容服务或自定义网关场景按服务商文档配置。 | 协议、路径和代理可达性;错误地址可能导致鉴权失败或请求发往非预期服务。 |
| 数据库方言 | 由当前连接提供,并可在提示中再次明确 MySQL、PostgreSQL、SQLite 等。 | 分页、日期函数、引号、类型转换和 DDL 语法差异。 |
| Schema / 表上下文 | 选择当前数据库、Schema 与相关表;必要时在问题中说明字段和关联键。 | 同名表、过期元数据、缺失外键与跨 Schema 引用。 |
| 当前 SQL / 结果上下文 | 选中需要解释的 SQL,或在查询成功后基于当前结果追问。 | 选区是否完整、结果是否被截断、样例行能否代表全量数据。 |
| 输出约束 | 明确只读、返回列、时间范围、排序、LIMIT,以及“只生成不执行”。 | 模型可能遗漏约束,生成后仍需逐项核对。 |
预期结果
完成流程后,应得到一条可追溯、可审阅、可验证的候选 SQL,而不是直接把自然语言回答当成数据库结论。建议按以下清单验收:
- 生成 SQL 使用当前连接对应的方言,引用的表、字段与关联键确实存在。
- 筛选范围、时间边界、聚合口径、排序和 LIMIT 与原始需求逐项对应。
- 执行前已确认语句类型;任何写操作都有明确影响范围、备份或回滚安排。
- 解释内容能对应到实际 SQL 子句;优化建议已通过执行计划或实测耗时验证,而非仅凭模型措辞接受。
- 上下文问答能够追溯到展示的 SQL 和结果信息;当结果被分页、采样或截断时,结论明确标注该限制。
能力边界:模型可能生成不存在的字段、错误 JOIN、过时语法或看似合理但口径错误的结论,也无法替代数据库真实统计信息、执行计划和业务负责人确认。输出不准确时应缩小问题、补足 Schema,并回到数据库验证。
常见问题
为什么生成结果引用了不存在的表或字段?
先确认当前连接、数据库和 Schema 是否正确,再刷新或重新选择上下文。在提示中只列出相关表、关键字段与关联键,并要求模型不得臆造对象。生成后仍应使用对象树或元数据逐项核对。
Provider 配置后仍无法生成 SQL,怎么排查?
核对 API Key、模型名称和 Base URL 是否与服务商文档一致,并检查账号余额、模型权限、网络代理和服务商限流。可先用短提示验证基础连通性;不要通过反复提交大上下文来试错,以免增加费用。
AI 给出的优化 SQL 可以直接替换原语句吗?
不可以默认视为等价。先比较返回列、行数、NULL 处理、去重、排序和时间边界,再用相同参数与边界数据对比结果;随后检查真实执行计划和耗时。写操作还必须在测试环境验证影响行数和回滚路径。
如何减少敏感数据发送给模型?
优先只提供表结构、脱敏字段名和最小必要 SQL,不粘贴凭据、完整结果集或个人敏感值。使用结果上下文前先判断其是否会进入模型请求,并遵守组织对第三方 AI 服务、数据驻留和保留策略的要求;无法确认时不要发送。
AI 回答与查询结果不一致怎么办?
以数据库实际执行结果为准。检查 AI 是否只看到分页、样例或截断数据,生成 SQL 是否遗漏过滤条件,以及追问时上下文是否已经切换。必要时新建会话,附上明确口径,并让 AI 先复述条件再生成 SQL。